

数据很少以单一整齐的格式交付。合作伙伴可能给你一份 CSV 导出文件,内部 API 可能把活动记录成 JSON,而分析管道可能把输出存为 Parquet。以往,要把这些内容全部汇入一张表,意味着你得分开暂存每种格式,并自己进行比对整合。Navicat 18 重新打造的导入向导正是瞄准这个问题;为了演示它的实际效果,我们将把三种不同的文件格式(基于 MySQL 的示例 classicmodels 数据库构建)合并到一张表中。
Parquet 加入格式清单
Parquet 现在成了可与导入向导现有格式清单(CSV、JSON、XML、Excel、DBase 等)并列的可选源格式。具体而言,对数据工程工作来说,这一点很重要:Parquet 是 Spark、Pandas 以及大多数云数据仓库等工具的默认输出格式,而能够不经转换就直接把它拉入一张表,确实补齐了一个真实的缺口。
一个界面,多个源,多张表
更大的变化是结构性的。新版的源文件与目标表界面不再让你为每个文件单独运行一次向导,而是允许你一次性添加多个不同格式的源,并各自独立地为每一个源指定目标表。把两个文件指向同一个目标,它们的数据就会在导入时合并到一张表里,而不再需要分多次处理。
动手试试:将三种格式合并到一张表
假设你有三份按地区划分的独立的客户文件:面向欧洲的 JSON 文件、面向美洲的 CSV 文件,以及面向其余所有地区的 Parquet 文件。现在你想把这三份文件合并到一张全新的表中。以下是在 Navicat 18 中的操作步骤:
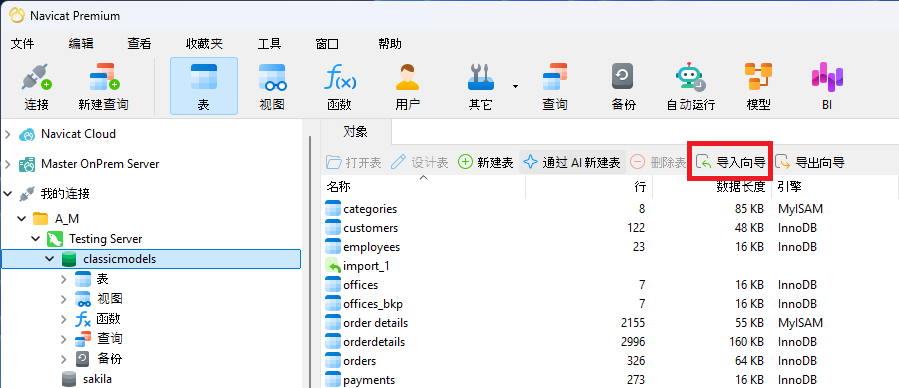
- 在主 Navicat 窗口中,在导航窗格中选择表,然后点击对象工具栏上的导入向导按钮。下方图片中该按钮以红色高亮显示:
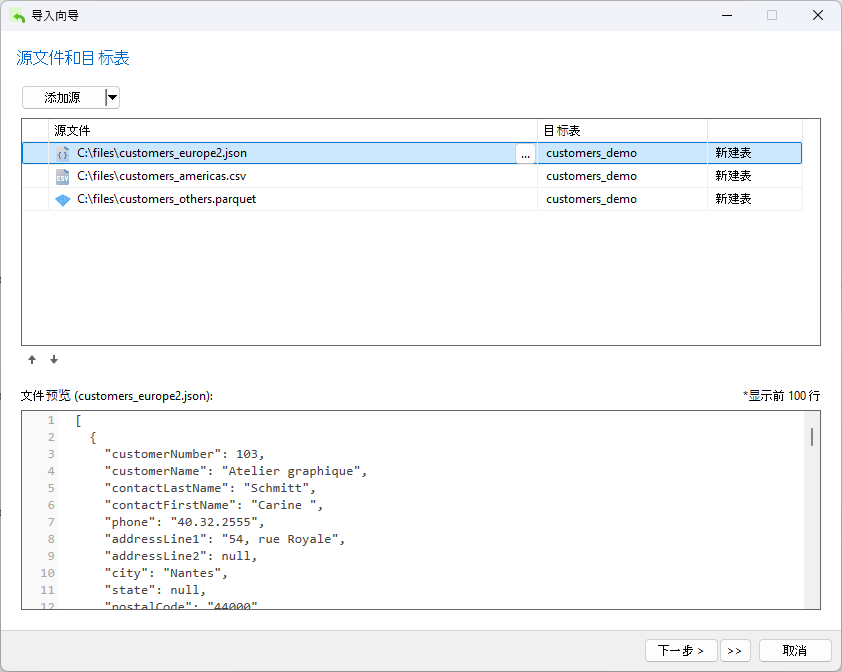
- 在源文件与目标表界面上,点击添加源,选择 JSON 文件(*.json),然后选中你的欧洲导出文件。
- 再次点击添加源,从下拉列表中选择 CSV 文件(*.csv),然后选中你的美洲导出文件。
- 再次点击添加源,选择 Parquet 文件(*.parquet),然后选中你其余地区的导出文件。
- 注意,Navicat 会自动将一个新建表指定为目标表。我们可以通过选择现有表或手动重命名来更改目标。对于三行中的每一行,都将目标表设置为 “customers_demo”。
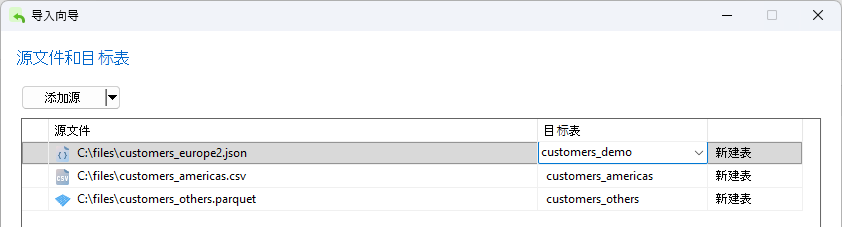
完成后,源文件与目标表界面应如下图所示:
- 点击下一步以查看每个源的字段映射。向导会将每种格式的原生类型协调成一个一致的目标模式,因此 CSV 字符串、JSON 键和 Parquet 列都会落入同一组字段中。在左侧选择每个源对应的
customers_demo时,我们可以查看结果预览窗格。Navicat 会在实际写入任何数据之前先渲染转换后的数据,这正是提交前发现不匹配列的绝佳时机。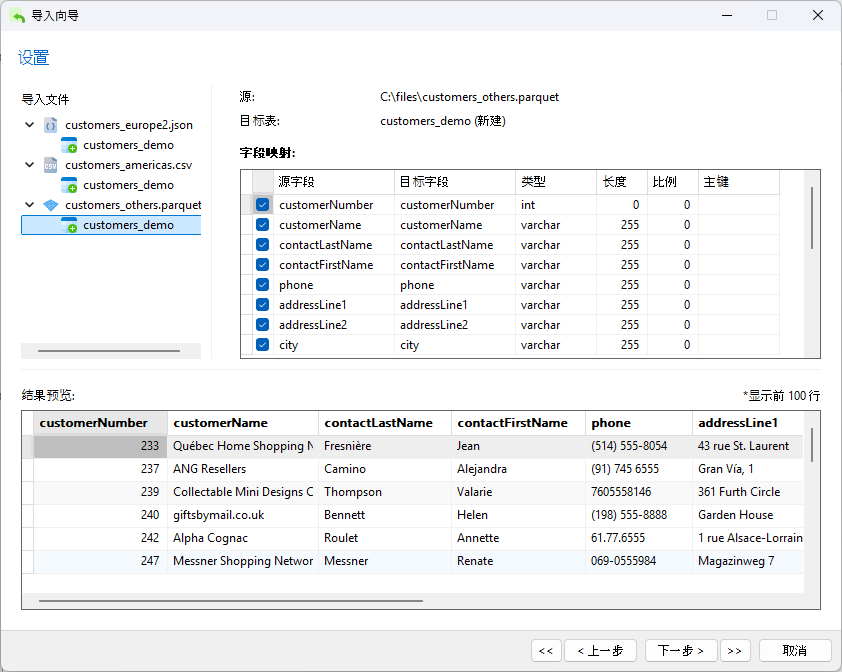
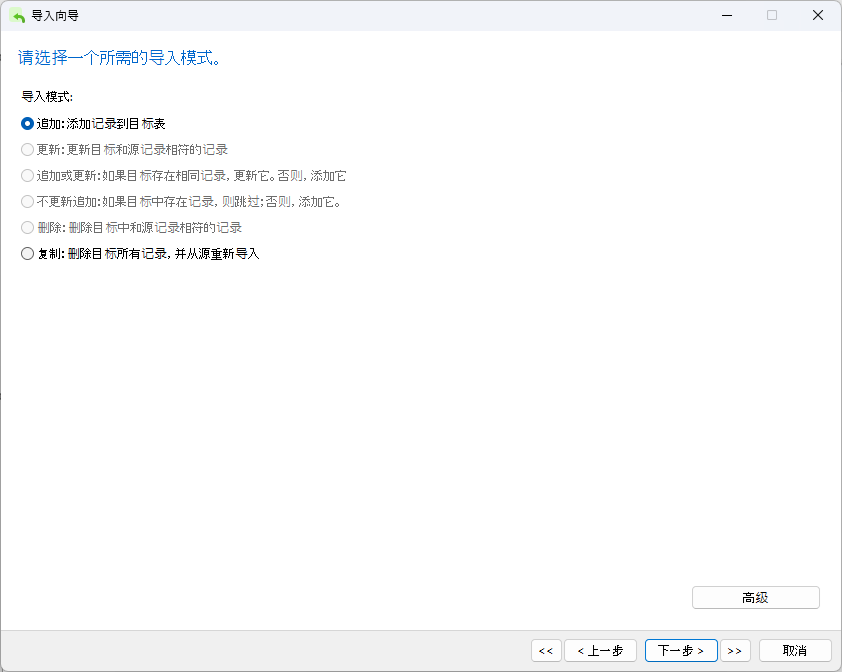
- 点击下一步以选择导入模式。在我们的例子中,只有两个可用选项:向目标表追加记录,或删除所有记录并从源重新填充。由于我们的目标表是全新的,我们将接受默认的追加选项。
- 点击下一步进入最后一步,然后点击开始运行导入。
Navicat 会在执行过程中生成一个输出日志。它会尝试为每个源创建
customers_demo表,这会让最后两个文件报错,因为到了那时该表已经存在。这并非问题,因为 Navicat 会直接继续追加新记录。事实上,我们可以在摘要中看到,全部 63 条记录都已成功添加。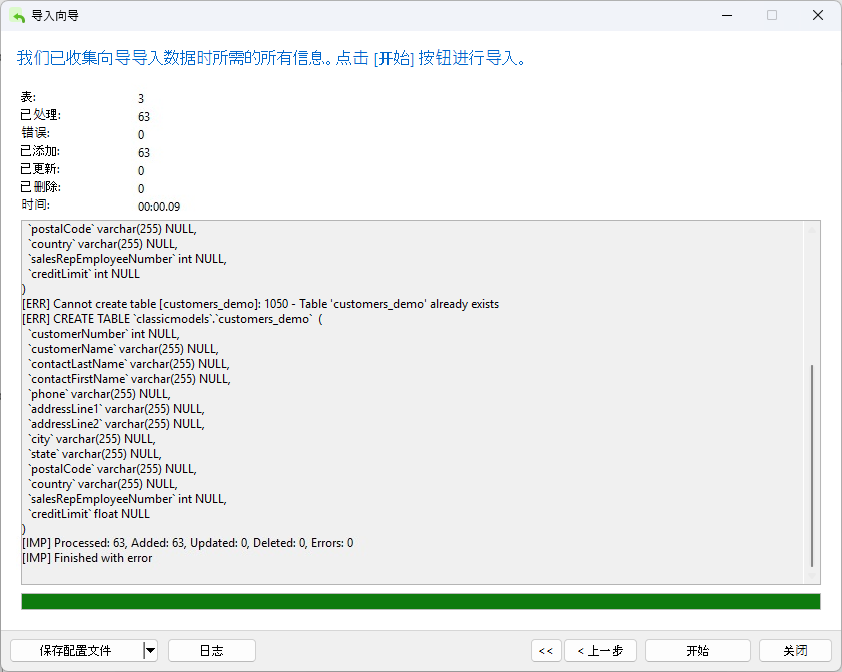
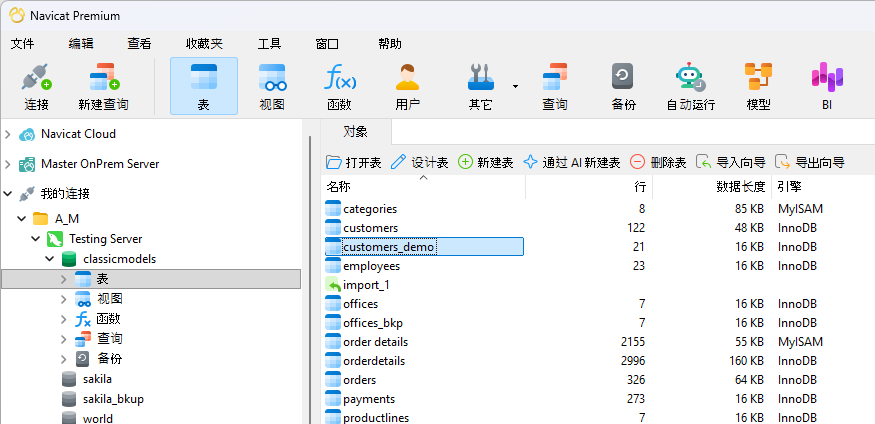
关闭向导后,新表就会出现在“对象”列表中:
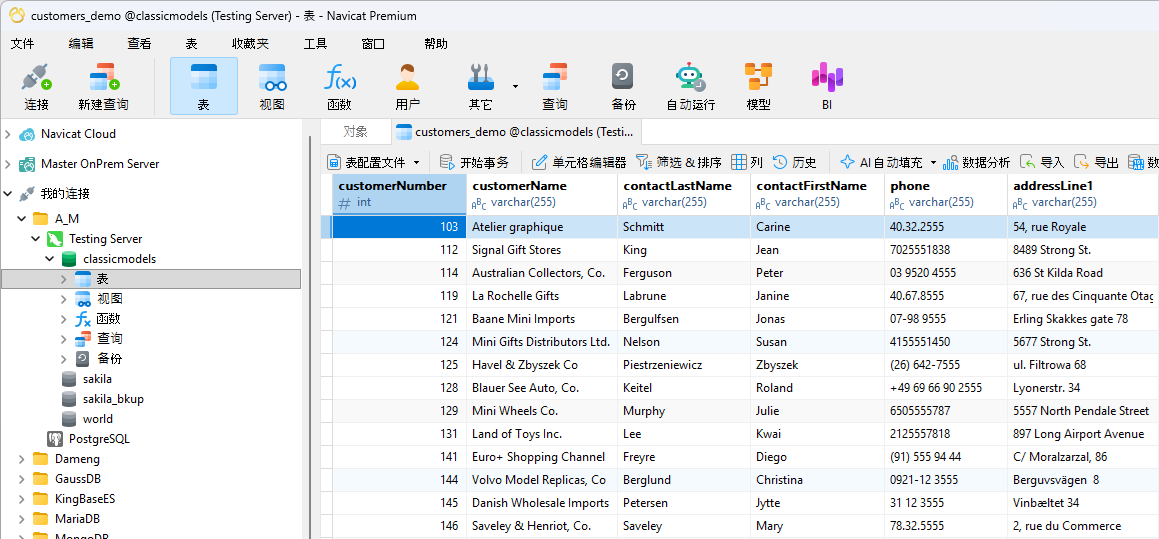
我们还可以打开该表,核实它已被填充数据:
为何值得了解
这并非一个花哨的功能,但对于任何需要定期做数据整合、把来自不同系统、无法就单一文件格式达成一致的各类导出文件汇集到一起的人来说,它确实非常实用。只需几次点击,就能让向导指向多个异构源并一次性将它们全部汇入一张表,从而取代了以往颇为费力的脚本编写工作。